Gemini 4 Argon, 벤치마크는 나왔고 써 본 사람은 아직 없다
Google이 9월 30일 발표한 Gemini 4 Argon은 아직 보안 파트너만 쓸 수 있다. 공식 비교표, Google 밖의 측정, 실제로 써 본 사용자 한 명의 말을 나눠서 정리했다.
X 원문 보기
임베딩이 보이지 않으면 X 원문에서 볼 수 있다.
Google은 2026년 9월 30일 새 프런티어 모델 Gemini 4 Argon을 발표했다. 발표 글은 Google DeepMind의 Koray Kavukcuoglu 수석 부사장이 썼고, 같은 날 Google AI 계정이 위 게시물을 X에 올렸다.
Google 블로그 — Gemini 4 Argon: our next era of frontier intelligence
발표 뒤 닷새 동안 Argon을 다룬 글은 많이 나왔다. 그러나 직접 써 보고 쓴 후기는 거의 없다. 지금 Argon을 쓸 수 있는 곳이 Google의 보안 파트너 프로그램뿐이기 때문이다. 이 글은 Google 발표를 원문 순서대로 정리한 뒤, Google 밖의 측정과 실제 사용자의 말이 어디까지 나왔는지 나눠서 본다. 기준일은 2026년 10월 5일이다.
Google이 소개한 Argon
Google은 Argon을 실제 코딩, 기업 지식 노동, 사이버 방어를 위한 모델로 소개한다. 길고 복잡한 작업 흐름에서 깊은 추론을 유지하도록 만들었다는 설명이다. 지식 노동의 예로는 법률과 금융을 든다.
발표에서 가장 큰 숫자는 출력 한도다. Google은 출력 토큰 한도를 이전 64K에서 100만 토큰으로 늘렸다고 썼다. 모델이 한 번에 내놓을 수 있는 출력의 길이를 말한다. 입력 맥락 창의 크기는 발표 글에 따로 적혀 있지 않다.
Google이 본문에 적은 성적은 다음과 같다.
- DeepSWE v1.1(에이전트 코딩): 77.9%, 최고 기록
- AutomationBench(Zapier의 업무 자동화 평가): 51.3%, 1위
- LVBench(긴 영상 이해): 91.7%
- CWE-bench v1(보안 취약점 탐지): 68%, 공동 1위
금융·코딩·법률·세무를 묶은 Vals Index, 금융 리서치 과제를 보는 Vals Finance Agent v2, 하비(Harvey)의 법률 에이전트 평가에서도 선두라고 적었다. 이 세 평가의 점수는 본문에 없다.
보안 파트너에게 먼저 준 이유
Google은 Argon을 사이버 방어에 강하도록 훈련했다고 밝혔다. 그래서 첫 공개 대상을 Fairwind 프로그램의 "신뢰할 수 있는 사이버 방어자"로 정했다. 이들과 Google 내부 팀에는 사이버 가드레일, 곧 공격에 쓰일 만한 요청을 거절하는 장치를 끈 채로 Argon을 제공한다.
사례로는 보안 기업 Wiz를 들었다. Google에 따르면 Wiz는 Argon으로 전 세계 병원이 쓰는 의료 소프트웨어에서 민감한 개인정보를 노출하는 심각한 취약점을 찾았다. 이전 프런티어 모델들이 놓친 취약점이었다고 한다.
오용을 막는 장치도 나열했다. 사이버·CBRN(화학·생물·방사능·핵) 공격 요청을 거절하도록 한 훈련, 모델 내부 활성값 감시, 사람과 자동화 도구를 함께 쓴 레드팀 시험, 프롬프트 인젝션 방어, 추론 과정과 행동의 정렬 이탈 감시, 격리된 시험 환경이다. Google은 이 수준의 능력을 안전하게 내놓으려면 단계적 공개가 필요하다고 썼다. 미국 정부의 자율적인 출시 전 모델 접근 절차에도 참여하고 있다고 밝혔다.
언제, 얼마에 쓸 수 있나
다음 공개 대상은 유료 API 고객과 Google AI Ultra 구독자다. 날짜는 없다. 발표 글은 "가능한 한 빨리(as soon as possible)"라고만 적었다.
가격은 먼저 정해 두었다. 도입가는 입력 100만 토큰당 2달러, 출력 100만 토큰당 10달러다. 캐시된 입력은 입력 가격에서 95%를 깎는다. 도입 기간이 끝나면 입력 4달러, 출력 20달러로 두 배가 된다. 도입가가 언제 끝나는지는 적혀 있지 않다.
실제로 열리지 않았다는 확인도 있다. eesel 블로그의 리뷰 작성자는 10월 1일 Gemini API에서 모델 ID 세 개로 Argon을 호출했고, 세 번 모두 404 NOT_FOUND를 받았다고 썼다. ZDL은 10월 5일까지 공개 범위를 넓혔다는 Google의 발표를 찾지 못했다.
공식 비교표: 긴 문서는 1위, 코딩은 갈린다
블로그 본문에는 경쟁 모델과 나란히 놓은 표가 없다. 비교표는 Google DeepMind의 Gemini 모델 페이지에 있다. 그중 네 항목을 GPT-6 Astra, Claude Opus 5.5와 함께 옮겼다.
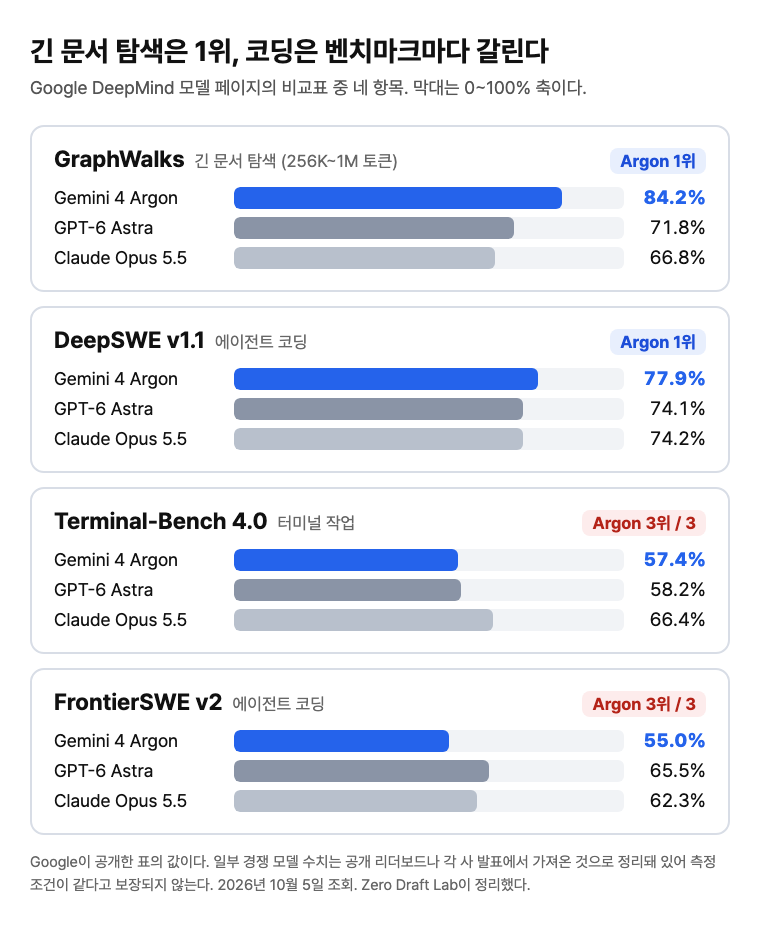
GraphWalks는 25만~100만 토큰 길이의 문서에서 연결 관계를 따라가는 평가다. 여기서 Argon은 84.2%로 Astra(71.8%)보다 12.4%p 높다. 코딩은 평가마다 결과가 갈린다. DeepSWE v1.1에서는 Argon이 77.9%로 가장 높다. FrontierSWE v2(55.0%)와 Terminal-Bench 4.0(57.4%)에서는 셋 중 가장 낮다. FrontierSWE v2에서는 Astra가 65.5%, Terminal-Bench 4.0에서는 Opus 5.5가 66.4%로 앞선다.
표의 숫자를 그대로 맞대기 전에 측정 조건을 봐야 한다. 벤치마크별 출처를 정리한 Emergent의 글에 따르면, DeepSWE와 Terminal-Bench에서 Google은 Argon만 직접 돌리고 경쟁 모델 값은 리더보드나 각 사 시스템 카드에서 가져왔다. GraphWalks는 Google이 세 모델을 모두 돌렸다.
Google 밖의 측정: 덜 틀리고, 더 길게 쓴다
Google 밖의 대표적인 측정은 Artificial Analysis다. 10월 5일 조회 기준으로 Argon(high 설정)은 이 회사의 Intelligence Index에서 53점을 받아 224개 모델 중 8위다. 이 지수를 평가하는 동안 Argon이 출력한 토큰은 1억 1천만 개로, 중앙값 8,100만 개보다 많다. Artificial Analysis는 이를 "다소 장황하다(somewhat verbose)"고 적었다.
리뷰에서 가장 많이 인용되는 수치는 환각률이다. Artificial Analysis의 AA-Omniscience 평가는 답을 거절하거나 모른다고 해야 할 질문에 틀린 답을 내놓는 비율을 잰다. 여러 리뷰가 이 평가에서 Argon은 15%, GPT-6 Astra는 51%였다고 전한다. eesel 리뷰는 Argon이 맞힌 문제 수는 더 적지만, 추측하는 대신 모른다고 답한다고 정리했다. ZDL은 Artificial Analysis의 Argon 모델 페이지에서 이 값을 직접 확인하지 못했다.
써 본 사람의 말
Hacker News에 올라온 발표 글 스레드는 10월 5일 기준 1,699점, 댓글 1,186개다. 댓글 대부분은 지금 쓸 수 있는 Gemini 3.8 Flash와 Google의 코딩 도구 Antigravity를 쓴 경험담이다. ZDL이 스레드를 검색해 찾은 Argon 직접 사용 댓글은 하나다.
몇 주 동안 이 모델을 쓸 수 있었다. 내 업무와 상관없는 분야를 잔뜩 조사해야 해서 직접 하기 싫은 복잡한 일을 맡길 수 있는 첫 Gemini 모델이었다. 100% 믿을 수는 없지만 결과는 대개 내가 한 것보다 낫고, 결과를 검증하는 비용이 직접 하는 비용보다 훨씬 싸다. — summerlight, Hacker News
같은 댓글은 Google이 이 수준을 앞으로 몇 년 동안 유지할 수 있을지는 모르겠다고 덧붙였다. 사전 훈련 주기를 한 번 놓쳐 몇 달 뒤처졌던 구조적 문제를 고쳤는지 아직 모른다는 이유다. 어떤 경로로 Argon을 썼는지는 댓글에 나오지 않는다.
나머지 반응은 쓸 수 없다는 데 몰려 있다. Gemini AI Ultra와 ChatGPT Pro를 함께 구독한다는 한 사용자는 "드디어 Flash가 아닌 모델을 냈는데 일반 구독자는 기한 없이 못 쓴다. AI Ultra 요금을 낼 이유가 뭔가"라고 썼다. 다른 사용자는 지금까지 Gemini 모델들이 벤치마크만큼 실무에서 정확하지 않았다며, 접근을 열지 않고 벤치마크만 발표한 이번 출시도 같은 흐름일 수 있다고 봤다. 이 사용자는 Argon의 출력량이 많은 편이라는 점도 짚었다. 모델이 정말 똑똑해졌는지, 추론 토큰을 많이 써서 점수에 닿았는지 가늠할 때 이 숫자를 본다는 설명이다.
ZDL이 읽는 방법
여기부터는 ZDL의 해석이다. 지금 나온 근거는 Google이 낸 수치, 일반 공개 전의 독립 측정, 사용자 한 명의 인상이 전부다. 이 범위 안에서 읽어도 Argon의 강점과 약점은 비교적 뚜렷하게 갈린다.
긴 자료를 읽고 근거를 따라가는 일, 모를 때 모른다고 말해야 하는 일에는 기대할 만하다. GraphWalks와 AutomationBench 1위, 낮은 환각률, "검증하는 비용이 직접 하는 비용보다 싸다"는 사용자 인상이 같은 방향을 가리킨다. 터미널에서 돌아가는 코딩 에이전트 용도라면, 지금 숫자만으로는 Astra나 Opus 5.5에서 옮겨 갈 이유가 약하다.
비용은 단가만 보고 판단하기 어렵다. 같은 일을 시켜도 출력이 길면 출력 단가가 더 많이 붙는다. 도입가가 끝나면 단가도 두 배가 된다. Ultra나 API로 열리면 자기 업무 몇 건을 직접 돌려 정답률, 출력 길이, 작업당 비용을 재 보는 편이 남의 리뷰를 기다리는 것보다 빠를 것이다.
주의점
비교표의 경쟁 모델 수치 일부는 Google이 직접 잰 값이 아니다. 같은 벤치마크라도 실행 환경과 설정이 다르면 점수가 달라진다. Artificial Analysis의 수치는 일반 공개 전에 측정됐고, 나중에 공개되는 버전과 설정이 같다는 보장은 없다. 환각률 15%와 51%는 여러 리뷰가 인용한 값이며, ZDL이 원 페이지에서 확인한 값은 아니다.
가격과 공개 범위는 10월 5일 기준이다. 일반 공개 날짜와 도입가 종료 시점은 아직 정해지지 않았다. Hacker News의 직접 사용 후기는 한 사람의 인상이고, 그 사람이 Argon을 쓴 경로와 과제는 확인되지 않는다.
이 글을 읽고 나면, Argon의 수치 가운데 Google이 낸 값과 바깥에서 잰 값, 아직 아무도 확인하지 못한 값을 나눠 읽을 수 있다.