녹음 텍스트 변환, 파일을 밖으로 안 보내고 될까: 무료 FunASR 직접 돌려 봤다
인터넷 연결을 막은 채 무료 오픈소스 FunASR로 녹음을 글로 바꿔 봤다. 변환은 됐고 외부 연결은 0건이었지만, 한국어는 띄어쓰기가 깨져 나왔다.

회의 녹음을 글로 바꾸는 가장 쉬운 방법은 파일을 앱에 올리는 것이다. 그런데 그 녹음에 고객 이름이나 계약 조건이 들어 있으면 손이 멈춘다. 그래서 무료 오픈소스 FunASR로, 인터넷 연결을 막은 채 녹음을 직접 글로 바꿔 봤다. 변환은 됐고, 밖으로 연결을 시도한 기록은 한 건도 없었다. 다만 한국어 결과는 「조 금만 생각 을 하 면서」처럼 띄어쓰기가 깨져 나왔다.
이 도구를 처음 본 곳은 아래 소개글이다.
회의 녹음 받아쓰기, 인터넷 없이 되는 거였구나ㄷㄷ
— 도파민(Dopamine) l Nanotrading.xyz (@dopamine_crypto) October 29, 2026
알리바바 쪽 모델스코프가 푼 FunASR이라는 음성인식 툴킷인데
깃허브 별이 2.1만 개임
녹음 파일 넣으면 글자로 받아써주는 건 기본이고
문장부호 찍기, 말 끊긴 구간 잡기까지 같이 해줌
오프라인, 실시간 스트리밍, 작은 기기용까지
돌리는 pic.x.com/xIc6SriOSg
소개글이 가리키는 저장소는 https://github.com/modelscope/FunASR다. 아래에서는 저장소 원문에 적힌 내용과 ZDL이 직접 돌려 본 결과를 나눠서 쓴다.
FunASR은 무엇인가
먼저 저장소 원문 기준의 사실이다. FunASR은 스스로를 오프라인, 실시간 스트리밍, 작은 기기 배포에 쓰는 음성 인식 툴킷이라고 소개한다. 2026년 11월 4일 기준 GitHub 별은 20,933개다. 툴킷 코드는 MIT 라이선스이고, 원문은 사전 학습 모델의 라이선스가 코드와 따로라고 적는다.
원문의 CPU 예시는 SenseVoiceSmall이라는 모델을 쓴다. 원문 표 기준으로 이 모델은 중국어, 영어, 일본어, 한국어, 광둥어 다섯 언어를 받는다. 예시는 여기에 말소리 구간을 잡는 FSMN-VAD와 화자를 나누는 CAM++를 붙인다. 원문은 이때 나오는 화자 번호가 한 녹음 안에서만 쓰는 익명 번호이고, 누구 목소리인지 알아보는 기능은 아니라고 적는다.
직접 돌려 본 결과
여기부터는 ZDL 실측이다. 2026년 11월 4일, 맥 한 대에 파이썬 3.13 가상환경을 만들고 FunASR을 설치했다. 모델은 원문 CPU 예시와 같은 세 개를 썼다. 모델과 설정, 예제 파일을 처음 한 번 받는 데 약 1GB(966,478,505바이트)가 들었다. 받은 뒤에는 파이썬 안에서 네트워크 연결과 주소 조회를 막는 장치를 걸고 돌렸다.
입력은 공개 예제 두 개다. 하나는 원문 예시에 있는 중국어 음성(5.5초)이고, 다른 하나는 SenseVoiceSmall 모델 페이지에 있는 한국어 예제(4.6초)다. 한국어 예제는 16kHz 단일 채널 wav로 바꿔 넣었다.
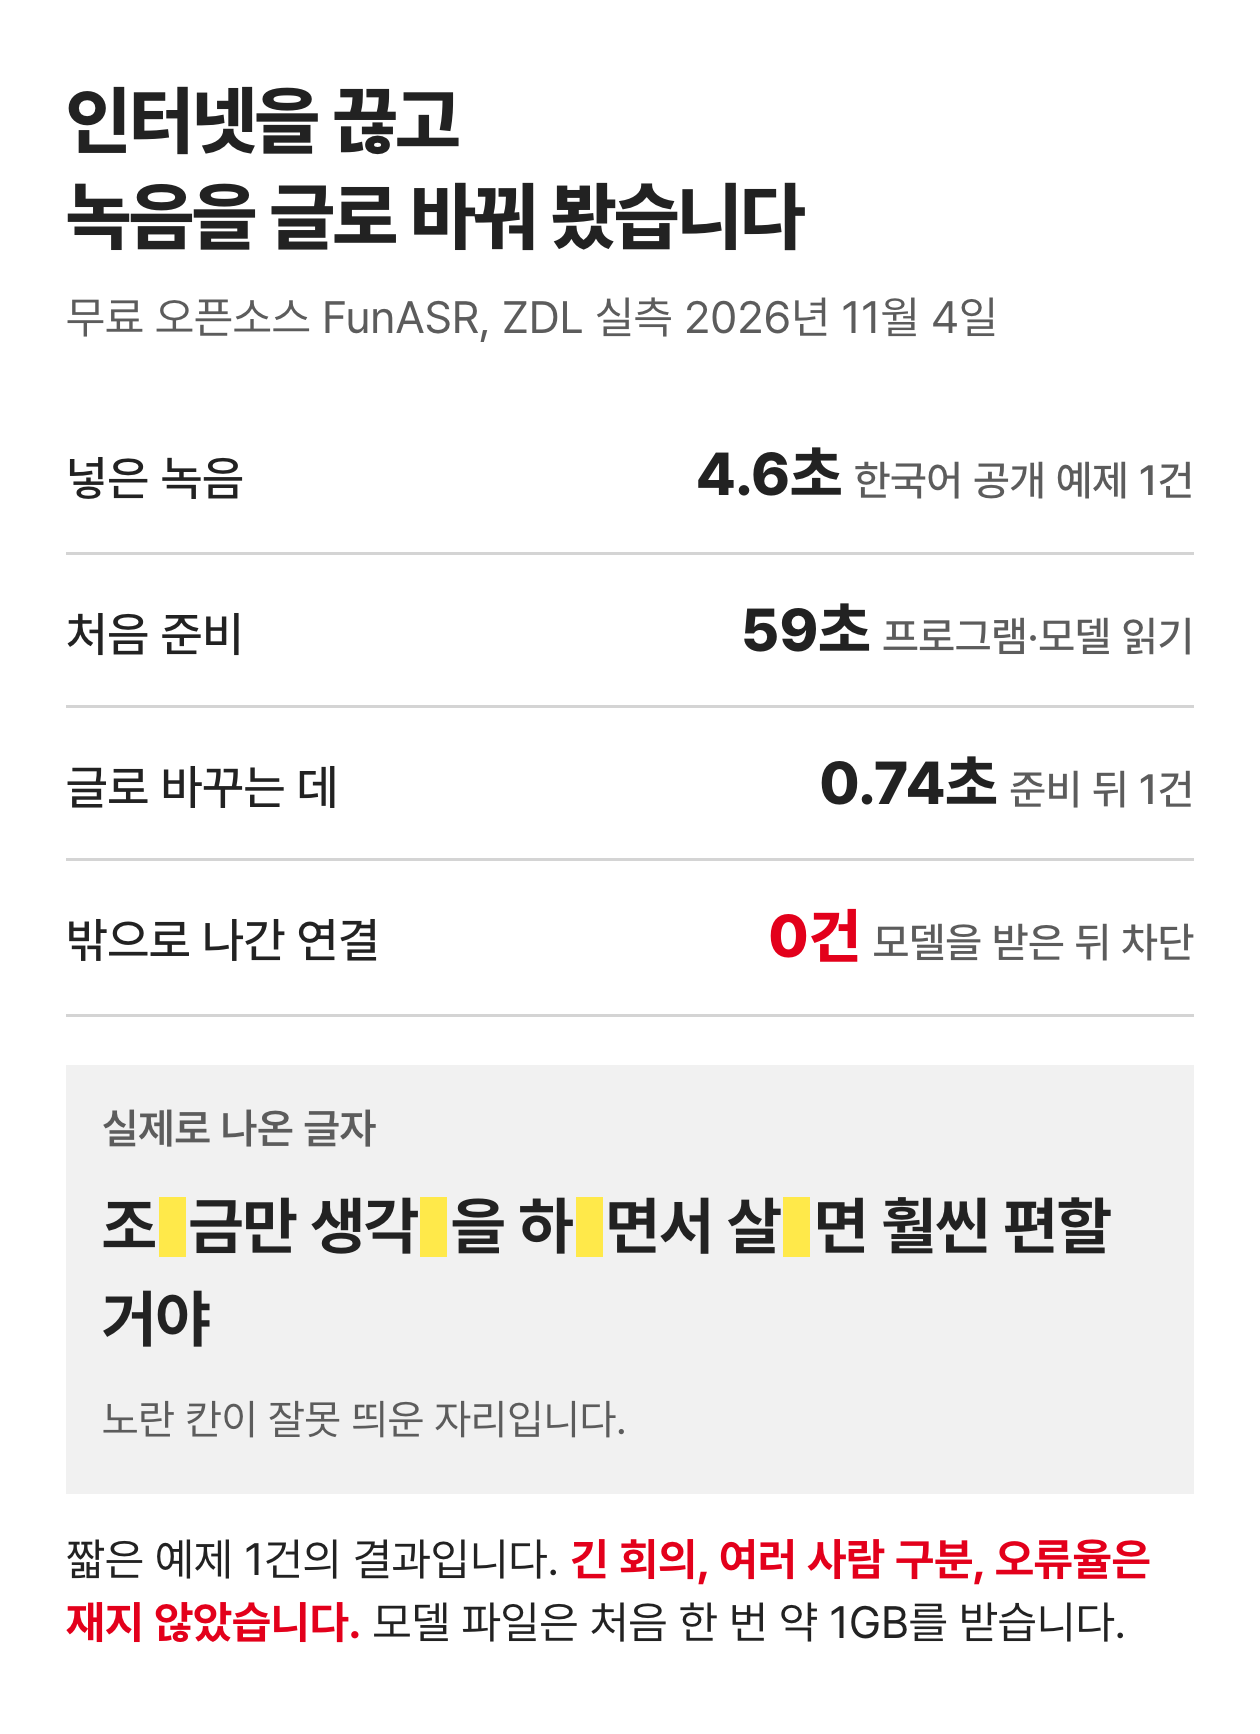
- 처음 준비: 프로그램과 모델을 읽는 데 59초가 걸렸다. 모델을 내려받은 시간은 뺐다.
- 변환 시간: 준비가 끝난 뒤에는 두 입력 모두 약 0.74초씩 걸렸다. 각 입력은 한 번씩만 돌렸다.
- 외부 연결: 변환하는 동안 연결을 시도한 기록은 0건이었다.
- 중국어 결과: 「欢迎大家来体验达摩院推出的语音识别模型」 한 문장이 0.61~5.53초 구간으로 나왔다.
- 한국어 결과: 「조 금만 생각 을 하 면서 살 면 훨씬 편할 거야」가 0.49~4.62초 구간, 화자 0번으로 나왔다. 글자 사이를 잘못 띄운 자리가 네 군데다.
실행 기록에는 오류 한 줄도 남았다.
ERROR Missing punc_model, which is required by spk_model.문장부호 모델이 빠졌다는 뜻이다. 프로그램은 멈추지 않고 결과를 끝까지 냈다. 그래서 「끝까지 돌았다」만 보고 「오류 없이 돌았다」고 판단하면 안 된다. 한국어 띄어쓰기가 깨진 원인이 이 오류와 관련 있는지는 확인하지 않았다.
이 결과로 말할 수 있는 것과 없는 것
말할 수 있는 것은 두 가지다. 인터넷 연결을 막아도 녹음이 글로 바뀐다. 짧은 파일은 준비만 끝나면 1초 안에 나온다.
말할 수 없는 것이 더 많다. 긴 회의 녹음에서 얼마나 정확한지, 여러 사람 목소리를 제대로 나누는지, 정답 대본과 비교한 오류율은 재지 않았다. 4.6초짜리 예제 1건으로 FunASR의 한국어 품질 전체를 판정하지 않는다.
라이선스도 따로 봐야 한다. 툴킷 코드는 MIT지만, 이번에 쓴 받아쓰기 모델은 모델 페이지의 약관을 따른다. 내 녹음을 내가 바꾸는 용도를 넘어 서비스에 넣을 생각이라면 그 약관부터 읽는다.
해 보려면
원문은 파이썬 3.8 이상에서 PyTorch와 torchaudio를 먼저 깔고 FunASR을 설치하라고 적는다.
pip install torch torchaudio
pip install funasr
그다음은 원문의 CPU 예시다. input 자리의 주소를 내 녹음 파일 경로로 바꾸면 된다. 처음 실행할 때는 모델을 받아야 하므로 인터넷이 필요하다. 인터넷 없이 돌릴 수 있는 것은 모델을 받은 다음부터다.
from funasr import AutoModel
from funasr.utils.postprocess_utils import rich_transcription_postprocess

model = AutoModel(model="iic/SenseVoiceSmall", vad_model="fsmn-vad", spk_model="cam++", device="cpu")
result = model.generate(
    input="https://isv-data.oss-cn-hangzhou.aliyuncs.com/ics/MaaS/ASR/test_audio/asr_example_zh.wav",
    batch_size_s=300,
)
누구에게 맞나
여기부터는 ZDL의 판단이다.
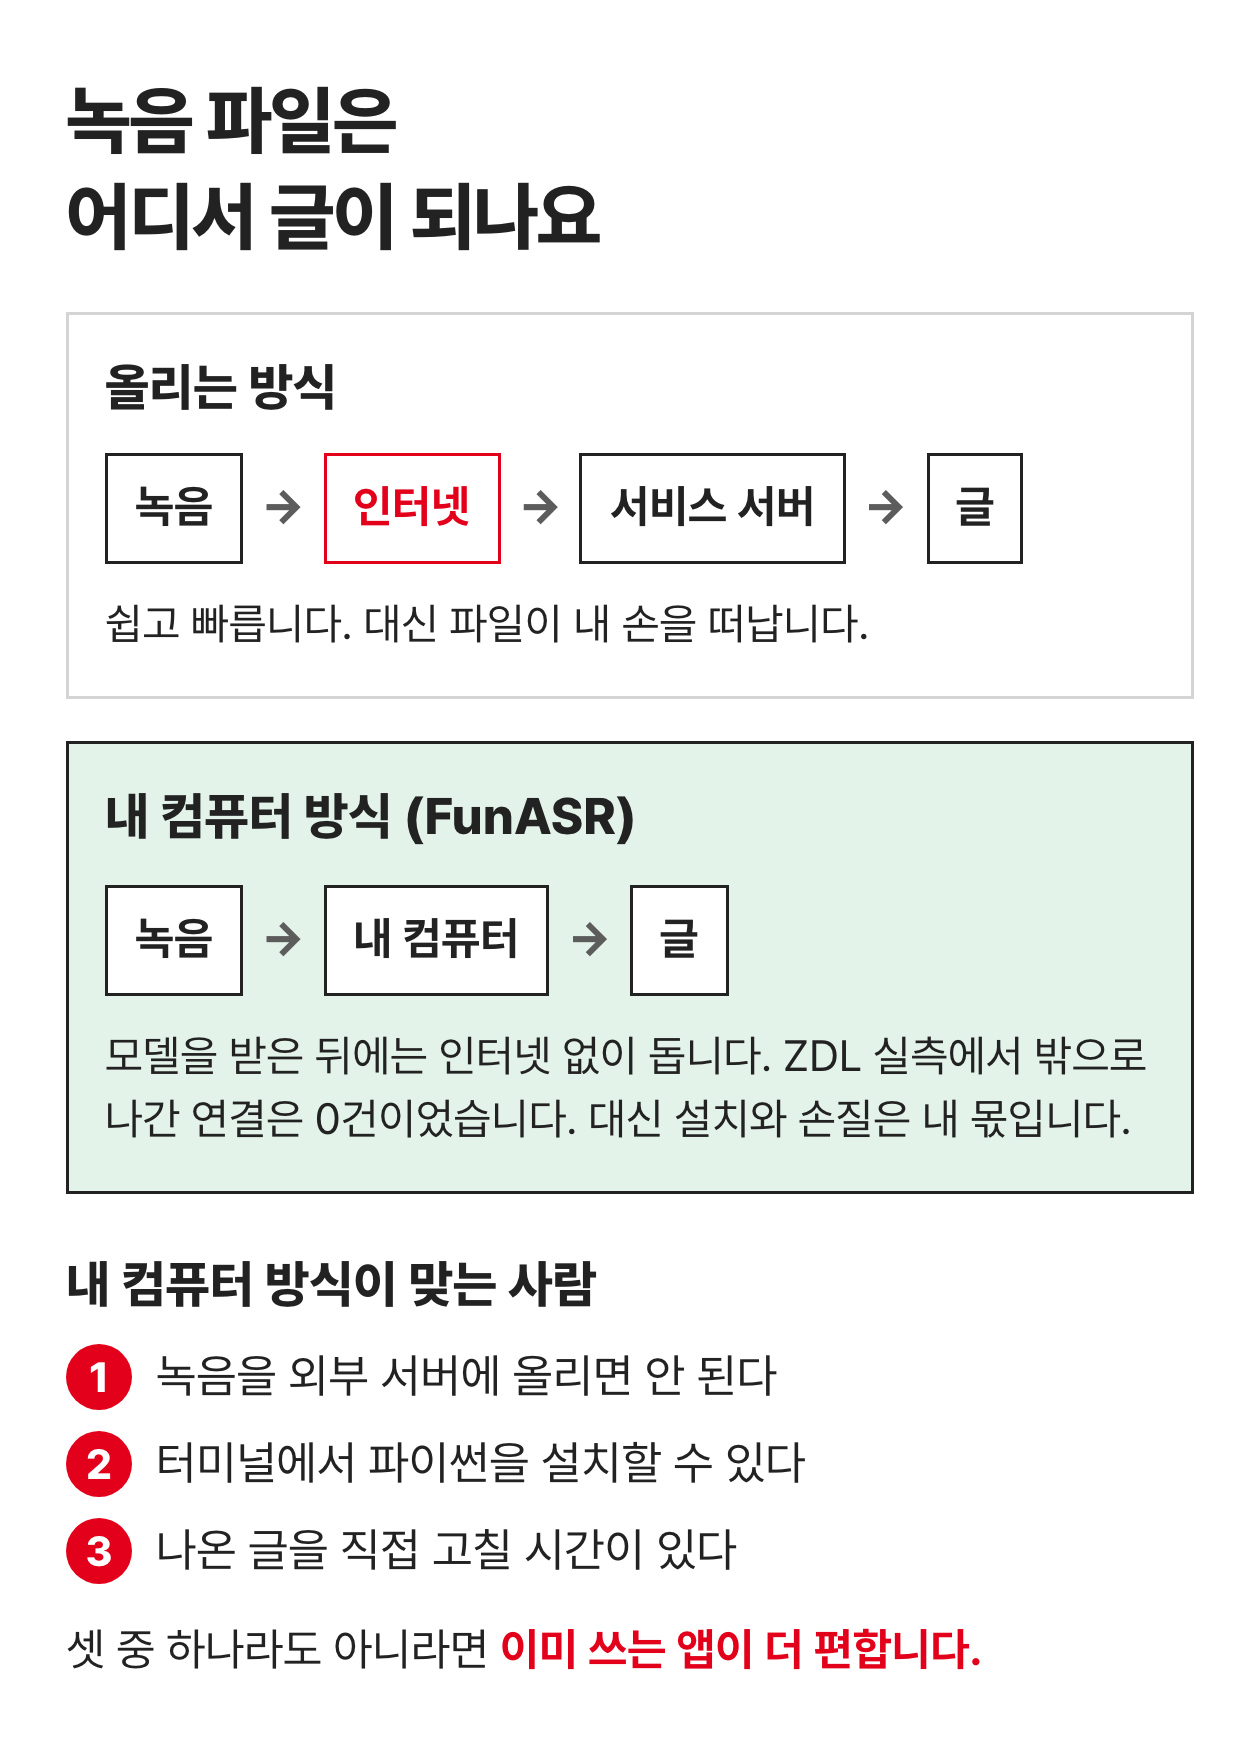
FunASR이 맞는 사람은 세 조건을 모두 갖춘 사람이다. 녹음을 외부 서버에 올리면 안 되고, 터미널에서 파이썬을 설치할 수 있고, 나온 글을 직접 고칠 시간이 있다. 셋 중 하나라도 아니라면 이미 쓰는 앱이 더 편하다.
휴대폰 기본 녹음 앱이나 받아쓰기 서비스의 정확도와 처리 위치는 이번에 재지 않았다. 그쪽을 쓴다면 파일이 어디서 처리되는지 각 서비스 안내를 먼저 확인한다.